ทำไม AI ควรได้รับอนุญาตให้เรียนรู้จากข้อมูลขนาดใหญ่ — และทำไมคำว่า “ให้เทรนได้” ไม่ได้แปลว่า “เอาอะไรก็ได้ไปใช้ฟรี”
ทำไม AI ควรได้รับอนุญาตให้เรียนรู้จากข้อมูลขนาดใหญ่ — และทำไมคำว่า “ให้เทรนได้” ไม่ได้แปลว่า “เอาอะไรก็ได้ไปใช้ฟรี”
ทำไม AI ควรได้รับอนุญาตให้เรียนรู้จากข้อมูลขนาดใหญ่ — และทำไมคำว่า “ให้เทรนได้” ไม่ได้แปลว่า “เอาอะไรก็ได้ไปใช้ฟรี”
เวลาเถียงเรื่อง AI เรามักเห็นบทสนทนากระโดดไปสุดสองฝั่งเร็วมาก
ฝั่งหนึ่งบอกว่า
“ถ้าไม่ได้ขออนุญาตเจ้าของงานทุกชิ้น ก็ไม่ควรเอาไปเทรนเลย”
อีกฝั่งบอกว่า
“ข้อมูลอยู่บนอินเทอร์เน็ตแล้ว จะเอาไปเทรนอะไรก็ได้”
สำหรับเรา สองประโยคนี้มีปัญหาเหมือนกันตรงที่มันทำให้เรื่องซับซ้อนกลายเป็นเรื่องง่ายเกินจริง
ถ้าถามเราในฐานะคนทำงานสร้างสรรค์ที่ใช้ AI-assisted workflow ด้วย เราคิดว่า AI ควรสามารถเรียนรู้จากข้อมูลขนาดใหญ่และหลากหลายได้
แต่ประโยคนี้ไม่ได้แปลว่า
บริษัทควรมีสิทธิ์ขโมยไฟล์จากเว็บเถื่อน
ไม่ต้องสนใจที่มาของข้อมูล
ไม่ต้องรับผิดชอบเรื่อง memorization
หรือไม่ต้องเคารพกฎหมายของแต่ละประเทศ
สองเรื่องนี้อยู่ด้วยกันได้
เราสามารถเชื่อว่า AI จำเป็นต้องเข้าถึงข้อมูลขนาดใหญ่เพื่อพัฒนา พร้อมกับเชื่อว่า วิธีได้มาของข้อมูลและวิธีใช้ข้อมูลต้องมีกติกา
และสำหรับเรา นี่ต่างหากคือจุดที่ควรคุยกัน
เพราะ AI ที่จะใช้กับคนจำนวนมาก ต้องเรียนรู้โลกที่กว้างกว่าคนกลุ่มเดียว
Foundation model ไม่ได้ถูกสร้างมาเพื่อทำงานเพียงอย่างเดียว
เราต้องการให้มันเข้าใจภาษา
แปลภาษา
เขียนโค้ด
มองภาพ
อธิบายวิทยาศาสตร์
ช่วยค้นข้อมูล
ทำงานกับเสียง
เข้าใจบริบท
และประยุกต์สิ่งที่เรียนรู้ไปยังสถานการณ์ใหม่ที่มันไม่เคยเห็นตรง ๆ
โมเดลประเภทนี้จึงถูกนิยามจากการฝึกบนข้อมูลที่กว้าง แล้วนำความรู้นั้นไปปรับใช้กับงานจำนวนมาก Stanford อธิบาย foundation models ว่าเป็นโมเดลที่ฝึกจาก broad data at scale ก่อนนำไปประยุกต์กับงานปลายทางต่าง ๆ ส่วนงานวิจัย Chinchilla ก็เป็นตัวอย่างสำคัญที่แสดงว่า ภายใต้งบ compute เดียวกัน การเพิ่มข้อมูลฝึกอย่างเหมาะสมสามารถทำให้โมเดลขนาดเล็กกว่าทำผลงานดีกว่าโมเดลขนาดใหญ่ที่ได้รับข้อมูลไม่เพียงพอได้
พูดง่าย ๆ คือ
ถ้าเราอยากได้ AI ที่รู้จักโลกกว้าง เราก็ไม่สามารถสอนมันด้วยโลกที่แคบมาก ๆ แล้วหวังว่ามันจะเข้าใจทุกอย่างเอง
แต่คำว่า “ข้อมูลเยอะ” ยังไม่พอ
ข้อมูลต้อง หลากหลายและดี ด้วย
ถ้าเราเทรนโมเดลด้วยข้อมูลจากภาษาเดียว ประเทศเดียว ชนชั้นเดียว หรือมุมมองเดียว ระบบก็มีแนวโน้มที่จะเก่งกับโลกส่วนนั้นมากกว่าโลกส่วนอื่น ปัจจุบันช่องว่างด้านภาษายังเห็นได้ชัด โมเดลจำนวนมากทำงานกับภาษาอังกฤษและภาษาหลักบางภาษาดีกว่าภาษาที่มีข้อมูลน้อยอย่างมีนัยสำคัญ
ดังนั้นการมีข้อมูลที่กว้างไม่ใช่แค่เรื่องว่า
“บริษัทอยากเอาข้อมูลเยอะ ๆ เพื่อทำโมเดลให้ใหญ่ขึ้น”
แต่มันเกี่ยวกับคำถามว่า
ใครจะถูก AI เข้าใจ และใครจะถูกทิ้งไว้ข้างหลังด้วย
ถ้าข้อมูลภาษาไทย วัฒนธรรมไทย ศิลปะเอเชีย หรือบริบทของประเทศเล็ก ๆ มีน้อยกว่ามาก ผลลัพธ์ก็ไม่ควรทำให้เราแปลกใจถ้า AI เข้าใจโลกเหล่านั้นได้แย่กว่า
แต่ Data ขนาดใหญ่ไม่ได้หมายถึง “ยิ่งกวาดทุกอย่างยิ่งดี”
ตรงนี้ต้องพูดให้ชัด เพราะเป็นจุดที่ฝ่ายสนับสนุน AI เองก็ควรยอมรับ
ปี 2026 Stanford AI Index ชี้ถึงแนวโน้มสำคัญว่า งานวิจัยเริ่มให้ความสำคัญกับ คุณภาพ การ deduplicate การคัดเลือก และการจัดชุดข้อมูล มากขึ้น ไม่ใช่แค่เพิ่มปริมาณข้อมูลไปเรื่อย ๆ และมีหลักฐานเพิ่มขึ้นว่าข้อมูลคุณภาพต่ำหรือปนเปื้อนสามารถทำให้ประสิทธิภาพแย่ลงได้
NIST ก็เสนอให้มองเรื่อง provenance, ความครอบคลุม, representativeness, bias และคุณภาพของข้อมูลเป็นส่วนสำคัญของการสร้างระบบ AI ที่น่าเชื่อถือ
ดังนั้นข้อเสนอที่แข็งแรงกว่าคือ
AI ต้องการข้อมูลจำนวนมาก แต่ไม่ต้องการ “ขยะจำนวนมาก”
และยิ่งเรายอมรับตรงนี้ได้ การถกเถียงก็จะก้าวข้ามจาก
“เอาข้อมูลเยอะหรือไม่เยอะ”
ไปสู่คำถามที่ดีกว่าว่า
ข้อมูลอะไร
มาจากไหน
คุณภาพอย่างไร
ซ้ำแค่ไหน
เป็นตัวแทนของใครบ้าง
และมีสิทธิ์ใช้มันในบริบทนั้นหรือไม่
เหตุผลอีกข้อคือ “การเรียนรู้ Pattern” ไม่เหมือนกับการขายสำเนางานเดิมเสียทีเดียว
อันนี้เป็นหัวใจสำคัญของข้อโต้แย้งทางกฎหมาย
ในกระบวนการฝึกโมเดล ข้อมูลถูกประมวลเพื่อปรับ parameters หรือ weights ให้ระบบเรียนรู้ความสัมพันธ์และรูปแบบทางสถิติ
นี่ไม่ได้หมายความว่าโมเดลทุกชนิด “ไม่มีทางจำงานต้นฉบับ” เพราะ memorization เกิดขึ้นได้และต้องมีวิธีควบคุม
แต่มันก็ไม่ถูกต้องเหมือนกันที่จะอธิบายโมเดลทุกตัวว่าเป็น
“ฐานข้อมูลรูปหลายพันล้านรูป แล้วเวลาเจนก็ค้นรูปมาตัดแปะ”
นั่นไม่ใช่คำอธิบายทั่วไปที่ถูกต้องของวิธีทำงานของโมเดล generative สมัยใหม่
ความแตกต่างตรงนี้มีความสำคัญทางกฎหมายด้วย
ญี่ปุ่นถึงกับเขียนข้อยกเว้นไว้โดยเฉพาะใน Article 30-4 สำหรับการใช้ผลงานที่ไม่ได้มีวัตถุประสงค์เพื่อให้มนุษย์ “enjoy” ความคิดหรือความรู้สึกที่แสดงในงาน โดยเอกสารของ Agency for Cultural Affairs ยกตัวอย่างตรง ๆ ถึงการบันทึกผลงานลงฐานข้อมูลเพื่อใช้เป็น training data สำหรับพัฒนา AI โดยไม่ต้องขออนุญาตเจ้าของสิทธิในสถานการณ์ที่เข้าเงื่อนไขกฎหมาย
เรายกตัวอย่างญี่ปุ่นไม่ได้เพื่อบอกว่า
“ญี่ปุ่นทำแบบนี้ ดังนั้นโลกทั้งโลกต้องทำตาม”
แต่เพื่อให้เห็นว่า แนวคิดเรื่อง non-enjoyment / non-expressive use ไม่ใช่ข้อแก้ตัวที่บริษัทเทคโนโลยีเพิ่งคิดขึ้นมาลอย ๆ
มีระบบกฎหมายที่เลือกแยกมันออกจากการนำงานไปเผยแพร่ให้คนเสพโดยตรงจริง
คดีในสหรัฐฯ เองก็เริ่มแสดงให้เห็นว่า “Training” กับ “การเอาข้อมูลมา” อาจเป็นคนละคำถาม
คดี Bartz v. Anthropic เป็นตัวอย่างที่น่าสนใจมาก
ศาลวินิจฉัยว่าการทำสำเนาหนังสือของโจทก์เพื่อใช้ในกระบวนการฝึก LLM เป็น fair use ในคดีนั้น
แต่ศาลไม่ได้ให้ผลเหมือนกันกับการดาวน์โหลดหนังสือหลายล้านเล่มจาก pirate libraries แล้วสร้างเป็นคลังกลางของบริษัท โดยประเด็นนั้นไม่ได้รับการคุ้มครองด้วย fair use ในชั้น summary judgment เดียวกัน
เราชอบ distinction นี้มาก เพราะมันสะท้อนสิ่งที่เราคิดว่าเป็นวิธีมองปัญหาที่สมเหตุสมผลกว่า
มันไม่ได้บอกว่า
“AI ดี เพราะฉะนั้นทำอะไรก็ได้”
และไม่ได้บอกว่า
“มี copyrighted work เข้าไปใน pipeline เพราะฉะนั้นทุกอย่างผิดหมด”
แต่มันถามแยกกันว่า
คุณเอาข้อมูลมาอย่างไร
กับ
คุณเอาข้อมูลนั้นไปทำอะไร
เป็นคนละคำถาม
Meta ก็ชนะคดีหนึ่ง แต่ชัยชนะนั้นยิ่งแสดงว่ากฎหมายไม่ได้ให้ “ใบอนุญาตถาวร” แก่ AI
ใน Kadrey v. Meta ศาลให้ summary judgment แก่ Meta ในปี 2025 สำหรับข้อกล่าวหาของนักเขียน 13 คนเกี่ยวกับการใช้หนังสือฝึก Llama
แต่สิ่งที่น่าสนใจคือผู้พิพากษา Vince Chhabria เขียนอย่างชัดเจนว่า คำตัดสินนั้น ไม่ได้หมายความว่าการใช้ copyrighted material ฝึก LLM ของ Meta เป็นสิ่งชอบด้วยกฎหมายโดยทั่วไป
Meta ชนะจาก record ของคดีนั้น โดยเฉพาะเพราะโจทก์ไม่ได้นำหลักฐานเรื่อง market dilution ที่เพียงพอมาสนับสนุนทฤษฎีที่ศาลมองว่าอาจมีน้ำหนักได้
ตรงนี้ยิ่งทำให้ข้อเสนอว่า
“อนุญาตให้ AI เทรนได้ภายใต้กติกา”
แข็งแรงกว่า
“AI จะเทรนอะไรก็ได้ เพราะทุกอย่างเป็น fair use”
เยอะมาก
เพราะแม้แต่คำพิพากษาที่บริษัท AI ชนะ ศาลก็ยังไม่ได้พูดประโยคหลัง
แล้วถ้าบังคับว่าทุกชิ้นต้องขออนุญาตล่วงหน้าทีละชิ้นล่ะ?
ฟังดูง่ายในเชิงหลักการ แต่พอเอาไปใช้กับ foundation model ที่ต้องเรียนรู้จากข้อมูลจำนวนมหาศาล มันมีปัญหาทางปฏิบัติทันที
ใครเป็นเจ้าของสิทธิ์ของทุกหน้าเว็บ?
ต้องตามหาทายาทของหนังสือทุกเล่มหรือไม่?
งานที่มีเจ้าของหลายคนคิดอย่างไร?
งานที่เจ้าของสิทธิ์หาไม่เจอล่ะ?
งานที่มีทั้ง public domain และ copyrighted material อยู่ด้วยกันล่ะ?
และถ้าทุกข้อมูลต้องเจรจาสัญญาแบบ one-to-one ก่อนหมด บริษัทเล็ก มหาวิทยาลัย นักวิจัยอิสระ หรือโครงการ open-source จะสามารถแข่งขันกับบริษัทที่มีเงินหลายหมื่นล้านได้หรือไม่?
U.S. Copyright Office เองไม่ได้บอกว่า licensing ใช้ไม่ได้ ตรงกันข้าม สำนักงานสนับสนุนให้ตลาด licensing พัฒนาต่อ
แต่ก็ยอมรับตรง ๆ ว่า การที่ licensing สามารถทำได้ในบางอุตสาหกรรม ไม่ได้พิสูจน์ว่าการขอ license สามารถ scale ได้กับ training ทุกประเภท และเสนอว่าถ้าตลาดบางส่วนไม่สามารถแก้ช่องว่างเหล่านั้นได้ อาจต้องพิจารณากลไกอื่นเพิ่มเติม
สำหรับเรา นี่เป็นประเด็นใหญ่มาก
เพราะกติกาที่ตั้งใจจะปกป้องศิลปิน ถ้าออกแบบไม่ดี อาจมีผลข้างเคียงคือ
มีเพียงบริษัทที่รวยที่สุดในโลกเท่านั้นที่มีเงินซื้อข้อมูลพอจะสร้าง foundation model
ในขณะที่นักวิจัย มหาวิทยาลัย บริษัทเล็ก และ open models ถูกกันออกจากตลาด
ถ้าเกิดแบบนั้นจริง เราอาจไม่ได้แก้ปัญหาอำนาจของ Big Tech
เราอาจกำลังสร้างกำแพงให้ Big Tech สูงขึ้นด้วยซ้ำ
ข้อมูลขนาดใหญ่ยังมีคุณค่าในงานที่ไม่ได้มีเป้าหมายมา “แทนศิลปิน” เลย
เวลาพูด Generative AI คนมักนึกถึงภาพ เพลง หรือนิยายก่อน
แต่เทคโนโลยีพื้นฐานแบบเดียวกันถูกนำไปใช้กับวิทยาศาสตร์ การแพทย์ ภาษา การเข้าถึงข้อมูล การศึกษา โปรแกรมมิ่ง และงานวิจัยอีกจำนวนมาก
ดังนั้นคำถามเชิงนโยบายไม่ควรเริ่มจากสมมติฐานว่า
“ข้อมูลทุกชิ้นที่ถูกใช้ฝึก AI ถูกนำไปสร้างของเลียนแบบเพื่อขายแข่งกับเจ้าของเดิม”
บางระบบอาจมีความเสี่ยงแบบนั้นจริง
แต่บางระบบอาจใช้ข้อมูลเพื่อ classification, search, translation, accessibility, scientific analysis หรือ research ซึ่งผลลัพธ์ไม่ได้ทำหน้าที่ทดแทนงาน expressive ต้นฉบับแบบเดียวกันเลย
U.S. Copyright Office จึงสรุปในรายงานเรื่อง Generative AI Training ว่า แม้การใช้ copyrighted works ใน AI training หลายแบบอาจมีลักษณะ transformative แต่ fair use ต้องพิจารณาว่า ใช้งานอะไร มาจากแหล่งไหน ใช้เพื่ออะไร มีการควบคุม output อย่างไร และกระทบตลาดอย่างไร พร้อมยกความแตกต่างระหว่างระบบที่ใช้เพื่อ analysis/research กับระบบเชิงพาณิชย์ที่สร้าง expressive content แข่งขันกับงานต้นฉบับโดยตรง
นี่คือเหตุผลที่เราคิดว่า
ห้าม AI เทรนงานมีลิขสิทธิ์ทุกประเภทแบบเหมาเข่ง
ก็อาจหยาบเกินไปพอ ๆ กับ
อนุญาตทุกอย่างแบบไม่มีเงื่อนไข
สำหรับเรา “สิทธิในการเรียนรู้” กับ “สิทธิในการทำซ้ำ” ไม่จำเป็นต้องเป็นสิ่งเดียวกัน
เราคิดว่านี่เป็นหลักที่น่าจะใช้สร้างสมดุลได้ดี
AI ควรมีพื้นที่ในการเรียนรู้ pattern จากวัฒนธรรม ความรู้ ภาษา และงานที่มนุษย์สร้างขึ้น
แต่ถ้าระบบสามารถเรียกงานเดิมออกมาเกือบตรง ๆ
ทำซ้ำข้อความยาว ๆ
สร้างภาพที่มี substantial similarity
หรือถูกออกแบบให้เข้าไปแทนตลาดของงานเดิมอย่างชัดเจน
เรื่องนั้นควรถูกตรวจสอบอีกระดับหนึ่ง
เราไม่จำเป็นต้องเลือกว่าจะปกป้อง
AI
หรือ
ศิลปิน
อย่างใดอย่างหนึ่ง
เราอาจสร้างกติกาที่บอกว่า
ให้เรียนรู้ได้กว้าง
แต่ต้องรู้ว่าข้อมูลมาจากไหน
อย่าใช้แหล่งที่ผิดกฎหมาย
ลด memorization
มีมาตรการป้องกันการ reproduce งาน
เคารพ opt-out ในเขตอำนาจที่กฎหมายกำหนด
ใช้ licensing ในตลาดที่มันทำงานได้
และให้ความสำคัญกับผลกระทบต่อตลาดจริงมากกว่าการตัดสินจากคำว่า “AI” เพียงคำเดียว
สำหรับเรา แบบนี้สมเหตุสมผลกว่าทั้งสองสุดโต่ง
และมีเหตุผลอีกข้อที่เป็นเรื่องใหญ่กว่าบริษัท AI
มนุษย์สร้างความรู้ใหม่โดยไม่เคยเริ่มต้นจากศูนย์
นักเขียนอ่านนักเขียน
นักวาดดูภาพ
นักดนตรีฟังเพลง
นักวิทยาศาสตร์อ่านงานวิจัย
โปรแกรมเมอร์อ่านโค้ด
นักออกแบบเรียนประวัติศาสตร์การออกแบบ
วัฒนธรรมเติบโตจากการที่คนรุ่นหนึ่งรับสิ่งที่มีอยู่ก่อน แล้วสร้างบางอย่างต่อจากมัน
แน่นอน AI ไม่ใช่มนุษย์ และกฎหมายไม่จำเป็นต้องปฏิบัติต่อการเรียนรู้ของเครื่องเหมือนสมองมนุษย์ทุกประการ
แต่ถ้าในอนาคตเครื่องมือทางปัญญากลายเป็นโครงสร้างพื้นฐานที่คนหลายพันล้านคนใช้ในการเรียน การทำงาน การวิจัย และการสร้างสิ่งใหม่
คำถามว่า
“มันได้รับอนุญาตให้เรียนรู้จากวัฒนธรรมของมนุษย์ได้แค่ไหน”
ก็จะกลายเป็นคำถามใหญ่มาก
หากคำตอบคือ
“เฉพาะสิ่งที่บริษัทสามารถซื้อสิทธิ์ได้ทั้งหมดเท่านั้น”
เราควรถามต่อด้วยว่า
แล้วความรู้แบบไหนจะได้เข้าไปอยู่ใน AI?
ภาษาไหน?
ประเทศไหน?
วัฒนธรรมของใคร?
คนกลุ่มไหนมีเงินพอจะทำโมเดล?
และใครจะกลายเป็นเจ้าของโครงสร้างพื้นฐานทางความรู้ในอนาคต?
นี่เป็นเหตุผลที่เราไม่คิดว่าคำตอบควรเป็นการปิดประตูข้อมูลทั้งหมด
สิ่งที่ควรสร้างจึงไม่ใช่ AI ที่ “ไม่เคยเรียนจากใคร”
แต่คือ AI ที่เรียนรู้ภายใต้กติกาที่ดีกว่าเดิม
เราอยากเห็น model ที่รู้ว่าข้อมูลตัวเองมาจากไหนมากขึ้น
อยากเห็น dataset ที่ curated ดีกว่าเดิม
อยากเห็นการลดข้อมูลซ้ำ
อยากเห็นระบบป้องกัน memorization
อยากเห็น licensing ที่ใช้งานได้จริงในอุตสาหกรรมที่เหมาะสม
อยากเห็นเจ้าของสิทธิ์มีเครื่องมือจัดการสิทธิ์ที่ใช้งานได้
อยากเห็น transparency ที่ไม่ทำให้ข้อมูลส่วนบุคคลหรือความลับทางการค้าถูกเปิดหมด
และอยากเห็นกฎหมายแยกความแตกต่างระหว่าง
การเรียนรู้
การเก็บสำเนา
การเผยแพร่สำเนา
การสร้างงานใหม่
และการสร้างสิ่งที่เข้ามาทดแทนตลาดเดิม
ให้ละเอียดกว่าที่เป็นอยู่
เพราะท้ายที่สุดแล้ว เป้าหมายไม่ควรเป็นการสร้างโลกที่
AI พัฒนาได้ แต่ศิลปินอยู่ไม่ได้
และไม่ควรเป็นโลกที่
การปกป้องงานสร้างสรรค์ทำให้เครื่องมือทางความรู้รุ่นใหม่สามารถถูกสร้างได้โดยบริษัทที่รวยที่สุดไม่กี่บริษัทเท่านั้น
สิ่งที่เราควรพยายามสร้างคือพื้นที่ตรงกลางที่ยากกว่า
คือ
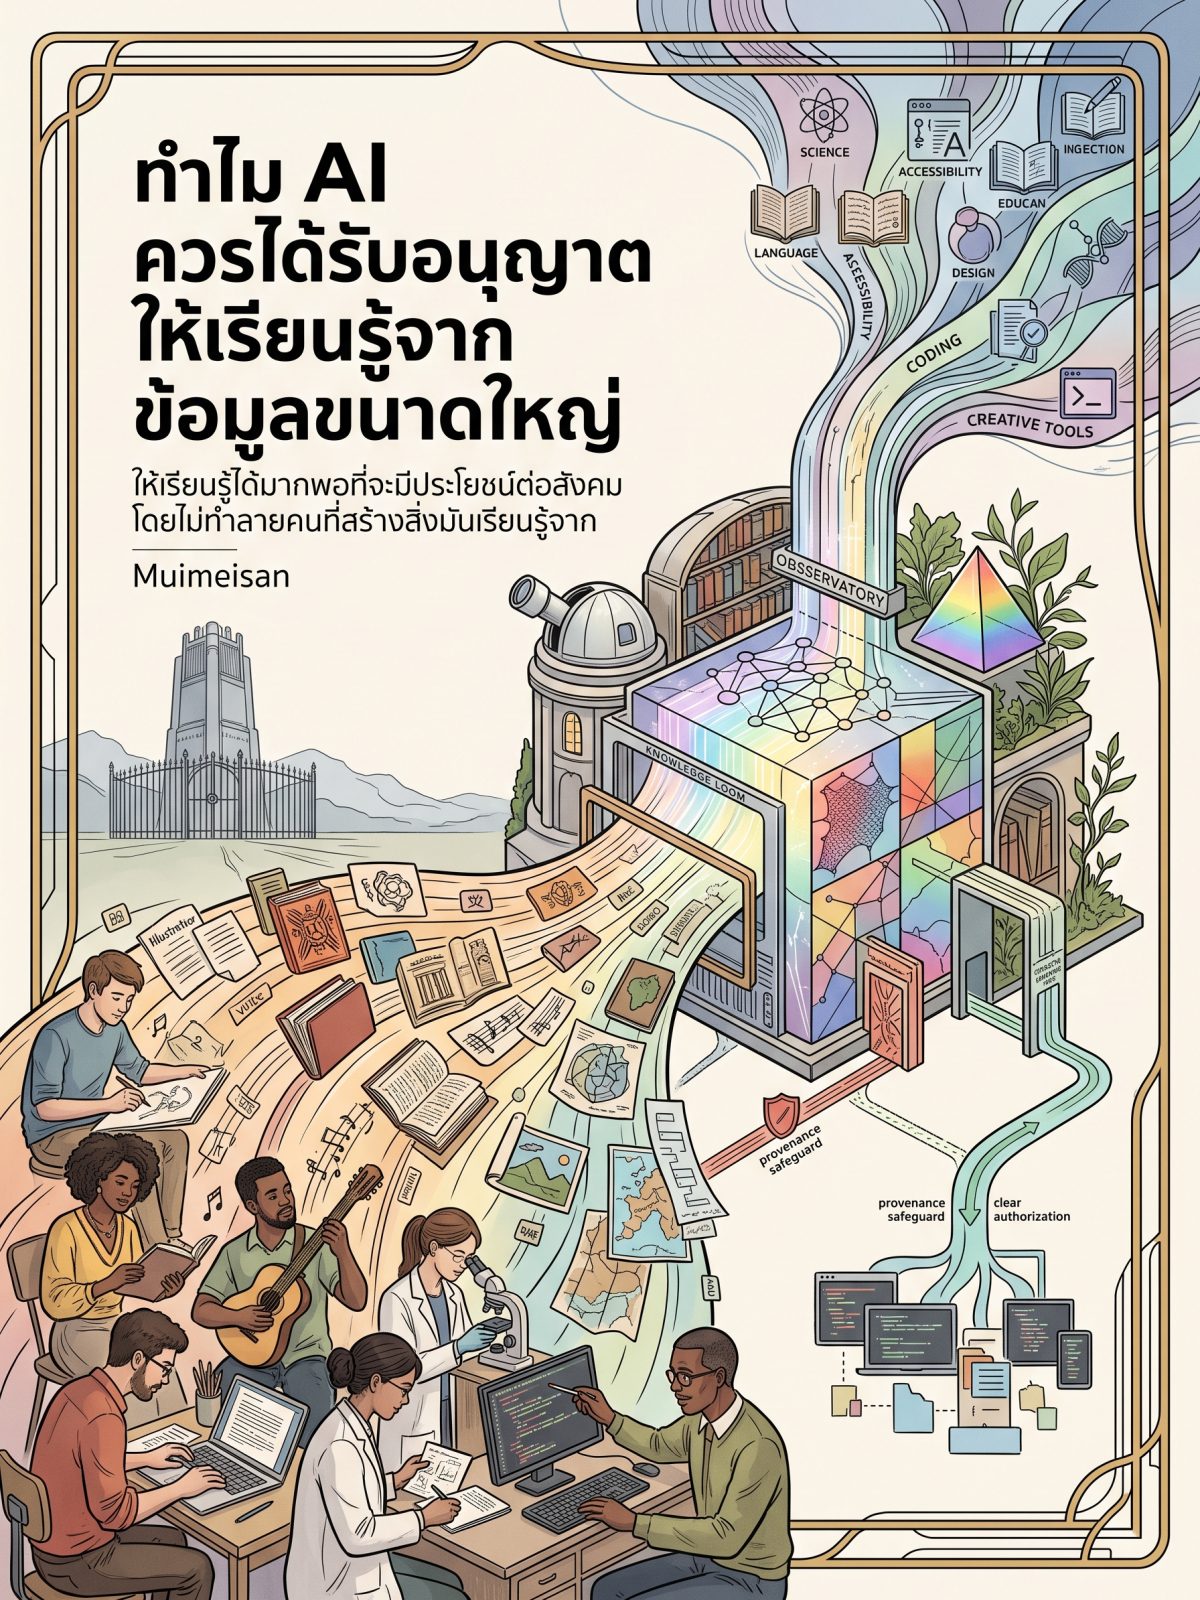
ให้ AI เรียนรู้ได้มากพอที่จะมีประโยชน์ต่อสังคม
พร้อมกับทำให้คนที่สร้างวัฒนธรรมซึ่ง AI เรียนรู้จากนั้น ยังมีเหตุผลและโอกาสที่จะสร้างงานชิ้นต่อไป
สำหรับเรา นั่นคือเหตุผลที่ AI ควรได้รับอนุญาตให้เทรนด้วยข้อมูลขนาดใหญ่
ไม่ใช่เพราะข้อมูลของมนุษย์ไม่มีเจ้าของ
ไม่ใช่เพราะศิลปินไม่มีสิทธิ์
และไม่ใช่เพราะเทคโนโลยีควรอยู่เหนือกฎหมาย
แต่เพราะ การสร้างปัญญาที่ใช้งานได้กับโลกจริง จำเป็นต้องเรียนรู้จากโลกจริงที่กว้างและหลากหลาย
สิ่งที่เราควรต่อรองกันจึงไม่ใช่ว่า
“AI ควรได้เรียนรู้อะไรเลยหรือไม่”
แต่คือ
เราจะอนุญาตให้มันเรียนรู้อย่างไร โดยไม่ทำลายคนที่สร้างสิ่งซึ่งมันเรียนรู้จาก
อันนี้สำหรับเราเป็นคำถามที่ยากกว่า
แต่ก็น่าจะเป็นคำถามที่ถูกกว่าด้วย