AI เทรนจากงานคนอื่น = ขโมย หรือ Fair Use? คำตอบจริงอาจไม่ได้อยู่ที่คำว่า “เทรน” เพียงคำเดียว
AI เทรนจากงานคนอื่น = ขโมย หรือ Fair Use? คำตอบจริงอาจไม่ได้อยู่ที่คำว่า “เทรน” เพียงคำเดียว
AI เทรนจากงานคนอื่น = ขโมย หรือ Fair Use? คำตอบจริงอาจไม่ได้อยู่ที่คำว่า “เทรน” เพียงคำเดียว
ช่วงนี้เราเห็นการถกเถียงเรื่อง AI กับลิขสิทธิ์อยู่สองขั้วบ่อยมาก
ขั้วหนึ่งบอกว่า
“AI ขโมยงานศิลปินไปเทรนทั้งหมด เพราะไม่ได้ขออนุญาต”
อีกขั้วหนึ่งบอกว่า
“AI แค่เรียนรู้ Pattern เหมือนมนุษย์ เพราะฉะนั้นไม่ผิดอะไร”
หลังจากลองอ่านคดีจริงมากขึ้น เรากลับรู้สึกว่า สองประโยคนี้ง่ายเกินไปทั้งคู่
เพราะคำถามที่ศาลกำลังพยายามตอบไม่ได้มีแค่ว่า
“AI ใช้งานมีลิขสิทธิ์ในการเทรนหรือไม่?”
แต่ต้องถามต่ออีกหลายชั้นว่า
เอาข้อมูลมาจากไหน
ได้มาอย่างไร
คัดลอกอะไรไว้
ใช้มันเพื่ออะไร
โมเดลทำอะไรกับมัน
ผลลัพธ์ออกมาเป็นอย่างไร
และสุดท้ายมันกระทบตลาดของเจ้าของงานหรือไม่
นี่ต่างหากที่ทำให้เรื่อง AI Copyright ซับซ้อนกว่าคำว่า “ขโมย” หรือ “Fair Use” เพียงคำเดียว
ก่อนอื่น ต้องแยก “Dataset” ออกจาก “Model” ก่อน
การฝึก Generative AI สมัยใหม่มักใช้ข้อมูลจำนวนมากเพื่อเรียนรู้ความสัมพันธ์และรูปแบบทางสถิติ ไม่ว่าจะเป็นภาษา ภาพ เสียง โครงสร้าง หรือองค์ประกอบต่าง ๆ
แต่การบอกว่าโมเดล “เรียนจากข้อมูล” ไม่ได้แปลว่าเรื่องลิขสิทธิ์หายไป เพราะในระหว่างการจัดหาและเตรียมข้อมูล อาจมีการดาวน์โหลด ทำสำเนา จัดเก็บ และประมวลผลผลงานอันมีลิขสิทธิ์เกิดขึ้นก่อนที่มันจะกลายเป็น parameters หรือ weights ของโมเดล
ในทางกลับกัน การบอกว่า “มีการทำสำเนาระหว่างกระบวนการ” ก็ไม่ได้แปลว่าศาลจะถือว่าทุกขั้นตอนเป็นการละเมิดโดยอัตโนมัติเช่นกัน
U.S. Copyright Office เองเสนอให้พิจารณาการใช้ผลงานในแต่ละช่วงของการพัฒนา AI แยกจากกัน เพราะการสร้าง dataset, pre-training, fine-tuning, RAG หรือการสร้าง output อาจมีวัตถุประสงค์และข้อเท็จจริงต่างกัน และจึงอาจได้ผลทางกฎหมายต่างกันด้วย
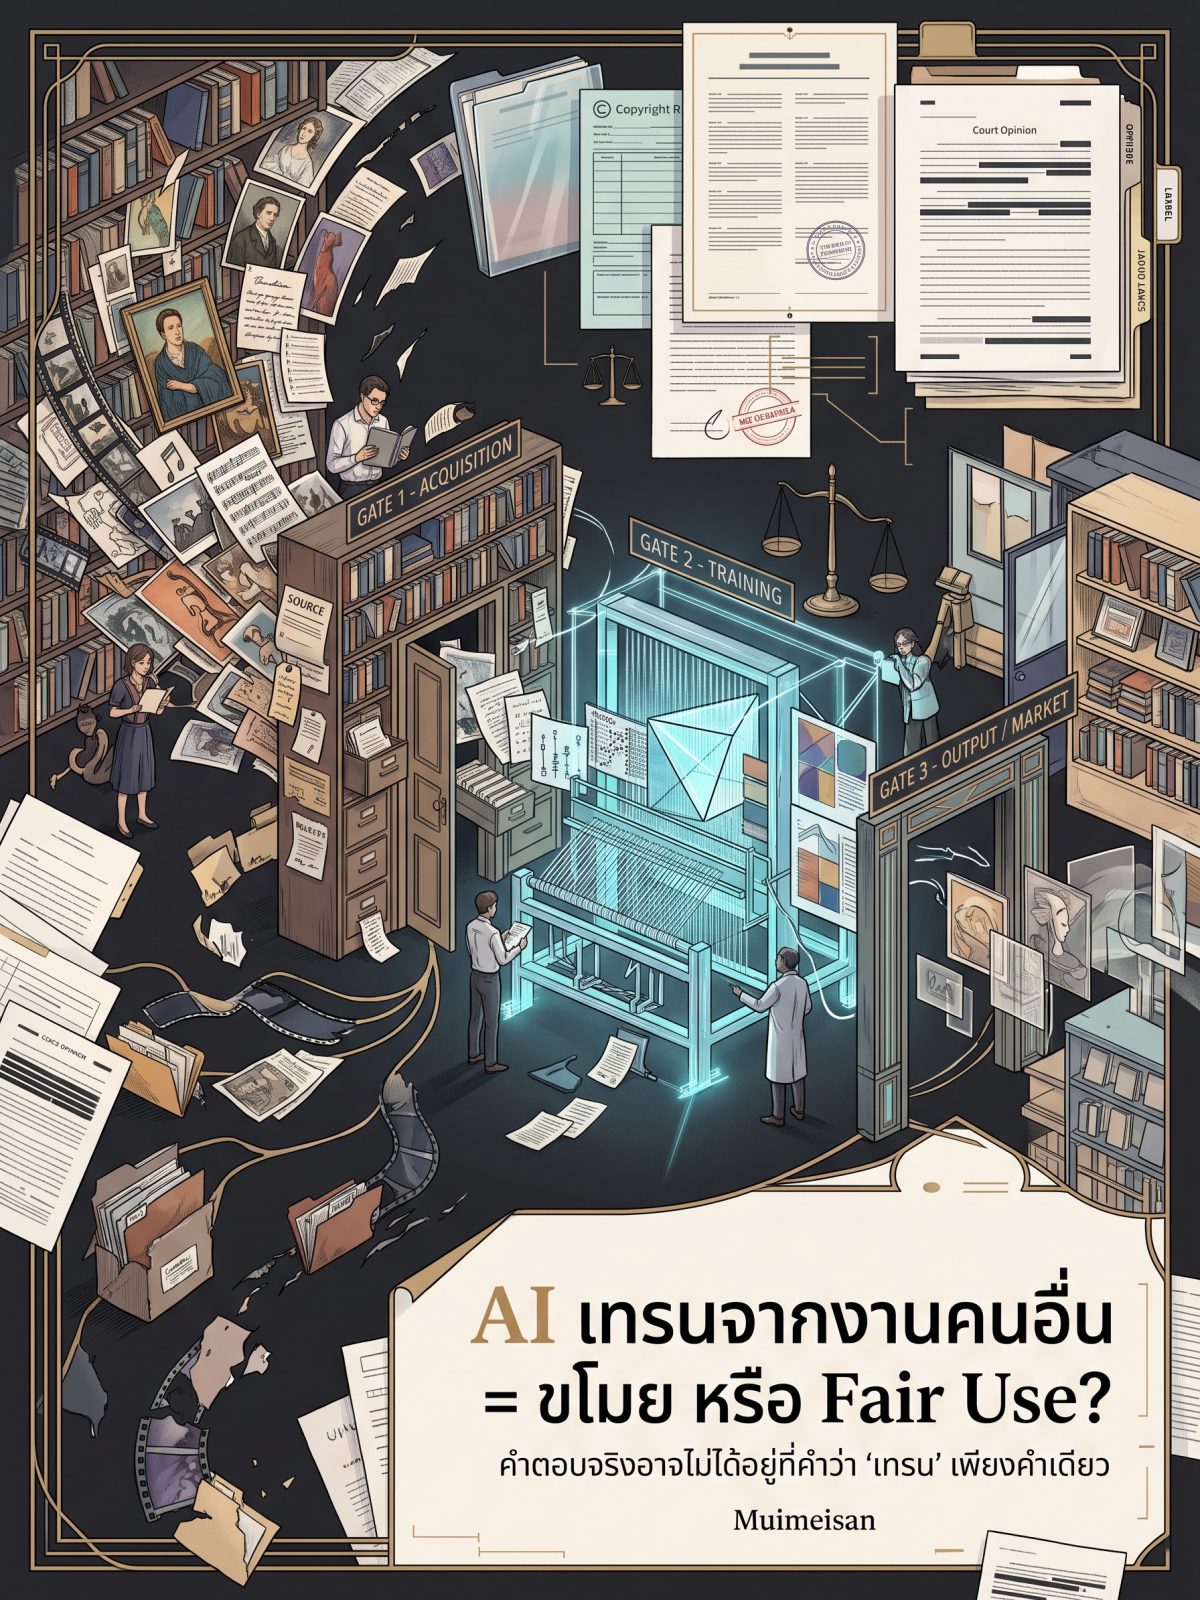
สำหรับเรา วิธีคิดที่ง่ายที่สุดคือแยกเรื่องนี้ออกเป็น สามประตู
ประตูที่หนึ่ง: ข้อมูลที่ใช้เทรน “ได้มาอย่างไร”
อันนี้สำคัญมาก และคดี Bartz v. Anthropic ทำให้เห็นภาพชัดที่สุดคดีหนึ่ง
ในเดือนมิถุนายน 2025 ผู้พิพากษา William Alsup แยกการกระทำของ Anthropic ออกเป็นคนละส่วน
การนำหนังสือของโจทก์ไปใช้ในกระบวนการฝึก LLM ถูกวินิจฉัยว่าเป็น fair use ในคดีนั้น และการซื้อหนังสือฉบับกระดาษแล้วแปลงเป็นดิจิทัลเพื่อใช้ในคลังภายในบางกรณีก็ได้รับการวินิจฉัยว่าเป็น fair use
แต่ศาล ไม่ได้ให้ผลแบบเดียวกันกับการดาวน์โหลดหนังสือหลายล้านเล่มจาก pirate libraries แล้วเก็บไว้เป็นคลังกลางของบริษัท โดยศาลไม่รับว่าการสร้างคลังดังกล่าวเป็น fair use ในชั้น summary judgment
นี่เป็น distinction ที่สำคัญมาก
เพราะมันแปลว่าเราสามารถมีสถานการณ์ที่
“เอาไปเทรน” อาจเป็น fair use
แต่
“วิธีที่คุณไปเอาไฟล์มาเก็บก่อนเทรน” อาจไม่ใช่ fair use
อยู่ในคดีเดียวกันได้
ภายหลัง Anthropic ตกลงยุติคดีแบบกลุ่มเป็นเงิน 1.5 พันล้านดอลลาร์ และศาลให้ final approval เมื่อวันที่ 20 กรกฎาคม 2026 โดย class ครอบคลุมเจ้าของสิทธิในหนังสือบางรายการจาก LibGen และ PiLiMi ที่ Anthropic ดาวน์โหลดไว้ การยุติคดีเป็น settlement ไม่ใช่คำพิพากษาหลัง trial ว่า Anthropic แพ้ทุกประเด็นของการเทรน AI
ดังนั้นถ้าใครบอกว่า
“Anthropic แพ้ เพราะศาลตัดสินว่าการเทรน AI ด้วยหนังสือมีลิขสิทธิ์ผิดกฎหมาย”
ก็ไม่ตรง
แต่ถ้าบอกว่า
“Anthropic ชนะ ดังนั้นโหลดหนังสือเถื่อนมาเทรนได้หมด”
ก็ไม่ตรงเหมือนกัน
ความจริงอยู่ตรงกลางและน่าสนใจกว่านั้นเยอะ
ประตูที่สอง: ตัว “Training” เองเป็น Fair Use หรือไม่
ตรงนี้สหรัฐฯ ยังไม่มีคำตอบแบบเหมารวมว่า
Generative AI training = Fair Use เสมอ
คดี Kadrey v. Meta เป็นตัวอย่างที่ดีมาก
เดือนมิถุนายน 2025 ศาลให้ summary judgment แก่ Meta ในข้อกล่าวหาที่ว่า Meta ละเมิดลิขสิทธิ์จากการนำหนังสือของโจทก์ 13 คนไปฝึก Llama
ถ้าอ่านแค่พาดหัว เราอาจสรุปทันทีว่า
“Meta ชนะ ศาลรับรอง AI Training แล้ว”
แต่ผู้พิพากษา Vince Chhabria เขียนไว้ชัดมากว่า คำตัดสินนี้ ไม่ได้หมายความว่าการนำงานมีลิขสิทธิ์ไปฝึก LLM ของ Meta โดยทั่วไปเป็นสิ่งชอบด้วยกฎหมาย
เหตุผลที่ Meta ชนะในประเด็นนี้คือโจทก์ชุดนั้นไม่สามารถสร้างหลักฐานเรื่อง market dilution ที่หนักพอใน record ของคดี ศาลถึงกับบอกตรง ๆ ว่าคำตัดสินมีขอบเขตจำกัดอยู่กับโจทก์ 13 คนเหล่านี้
ที่น่าสนใจยิ่งกว่านั้นคือผู้พิพากษาคนนี้ไม่ได้มีท่าทีว่า
“Transformative = จบ”
เขากลับเตือนว่า แม้การสร้างโมเดลจะมีลักษณะ transformative สูง แต่ถ้าผลิตภัณฑ์สามารถสร้างงานจำนวนมหาศาลที่เข้าไปแทนตลาดของงานต้นฉบับได้ ผลกระทบต่อตลาดอาจกลายเป็นเรื่องสำคัญมากในการวิเคราะห์ fair use
นี่ทำให้เราเห็นอะไรอย่างหนึ่ง
ศาลสองคดีที่ออกใกล้กันมากยังให้น้ำหนักบางปัจจัยไม่เหมือนกัน
เพราะ Fair Use ไม่ใช่สูตรคณิตศาสตร์
มันเป็น balancing test ที่ขึ้นกับข้อเท็จจริงของแต่ละคดี
แล้วมีคดีที่คนทำ AI แพ้ไหม? มี
คดี Thomson Reuters v. ROSS Intelligence เป็นตัวอย่างสำคัญ แม้ ROSS จะไม่ใช่ Generative AI แบบ ChatGPT หรือ Midjourney
ROSS ใช้ Westlaw headnotes ซึ่งเป็นข้อความที่บรรณาธิการกฎหมายของ Thomson Reuters สร้างขึ้น เป็นส่วนหนึ่งของกระบวนการสร้างระบบค้นคว้ากฎหมายที่เข้ามาแข่งขันในตลาดเดียวกัน
เดือนกุมภาพันธ์ 2025 ศาลแขวง Delaware กลับคำวินิจฉัยเดิมบางส่วนและตัดสินว่า ROSS ไม่สามารถใช้ fair use เป็นข้อแก้ต่างต่อการใช้ headnotes เหล่านั้นได้ โดยประเด็นเรื่องการแข่งขันทางตลาดมีน้ำหนักสำคัญ ขณะนี้คำวินิจฉัยดังกล่าวยังอยู่ในกระบวนการอุทธรณ์ จึงไม่ควรนำไปเขียนราวกับเป็นกฎสุดท้ายของศาลสูงสหรัฐฯ
และนี่ก็เป็นอีกเหตุผลที่เราไม่ควรพูดว่า
“ศาลสหรัฐตัดสินแล้วว่า AI Training เป็น Fair Use”
เพราะศาลยังไม่ได้สร้างกฎแบบนั้น
ส่วนคดีศิลปินกับ Image Generator ก็ไม่ได้จบแบบที่หลายโพสต์เล่ากัน
อีกเรื่องที่เราเห็นแชร์ผิดกันเยอะคือ Andersen v. Stability AI
มีคนสรุปว่า Stability AI, Midjourney และ DeviantArt “ชนะคดีศิลปินแล้ว”
จริง ๆ ไม่ใช่แบบนั้น
ในช่วงแรกศาลเคย dismiss ข้อกล่าวหาหลายส่วน แต่เปิดโอกาสให้โจทก์แก้คำฟ้อง และในคำสั่งเดือนสิงหาคม 2024 ศาล ปฏิเสธที่จะ dismiss copyright claims หลักหลายข้อ ต่อ Stability AI, Midjourney, Runway และ DeviantArt ทำให้ข้อกล่าวหาสำคัญดำเนินต่อไปเพื่อทดสอบด้วยหลักฐานในขั้นต่อ ๆ ไป
ดังนั้น
dismiss บาง claim ≠ บริษัท AI ชนะประเด็นการเทรนทั้งหมด
อันนี้ต้องแยกให้ดีมาก
ประตูที่สาม: AI สร้างอะไรออกมา
สมมติข้อมูลได้มาอย่างถูกต้อง และสมมติว่าการ training บางแบบผ่าน fair use
เรื่องก็ยังไม่จบ
เพราะ output เป็นอีกคำถามหนึ่ง
โมเดลสามารถสร้างงานใหม่ได้เป็นปกติ แต่บางกรณีก็มีประเด็นเรื่อง memorization หรือ regurgitation ซึ่งโมเดลอาจสร้างข้อความหรือองค์ประกอบที่ใกล้กับ training material มากผิดปกติ
และต่อให้ไม่ได้ reproduce งานต้นฉบับแบบตรง ๆ ก็ยังอาจเกิดข้อถกเถียงอีกชั้นเรื่อง market substitution
ดังนั้นคำถามไม่ควรมีแค่
“มันจำภาพต้นฉบับไว้หรือเปล่า?”
แต่ยังมี
“ผลลัพธ์สามารถทำหน้าที่แทนของเดิมในตลาดได้แค่ไหน?”
ด้วย
U.S. Copyright Office เองก็ย้ำว่า transformative use ไม่ได้ทำให้เป็น fair use โดยอัตโนมัติ และลักษณะของงานต้นฉบับ ปริมาณที่นำไปใช้ รวมถึงผลกระทบทางตลาดยังต้องถูกนำมาชั่งร่วมกัน
แล้วทำไมบริษัท AI ถึงต้องการข้อมูลเยอะขนาดนั้น?
เพราะโมเดลขนาดใหญ่ต้องเรียนรู้ pattern ที่หลากหลายอย่างมหาศาล
ภาษาไม่ได้มีแค่ศัพท์
ภาพไม่ได้มีแค่รูปทรง
มันมีความสัมพันธ์ระหว่างวัตถุ แสง สี พื้นผิว มุมมอง บริบท ภาษา วัฒนธรรม และรายละเอียดอีกมหาศาล
แต่เราก็ไม่ควรพูดเกินไปว่า
“AI จำเป็นต้องเอาข้อมูลทุกอย่างบนโลกมาเทรน ไม่อย่างนั้นจะมี bias”
เพราะปริมาณข้อมูลมากขึ้นไม่ได้รับประกันว่า bias จะลดลงโดยอัตโนมัติ
คุณภาพ การกระจายตัว การคัดเลือก การทำความสะอาด และวิธีฝึกโมเดลก็สำคัญ
และที่สำคัญที่สุดคือ
ความจำเป็นทางวิศวกรรมไม่ใช่ข้อยกเว้นทางกฎหมาย
ต่อให้บริษัทพิสูจน์ได้ว่า “เราจำเป็นต้องใช้หนังสือหนึ่งล้านเล่มเพื่อทำโมเดลให้ดี”
มันก็ยังต้องตอบอีกคำถามว่า
แล้วคุณมีสิทธิ์ได้หนังสือหนึ่งล้านเล่มนั้นมาจากไหน?
นี่เป็นคนละคำถามกัน
แต่ละประเทศก็ไม่ได้ตอบเหมือนอเมริกา
สหรัฐฯ ใช้หลัก Fair Use ซึ่งพิจารณาตามข้อเท็จจริงของแต่ละกรณี
แต่สหภาพยุโรปมีระบบ Text and Data Mining ที่เขียนไว้ในกฎหมายโดยเฉพาะ
Article 4 ของ Directive 2019/790 อนุญาตการทำ TDM กับงานที่เข้าถึงโดยชอบด้วยกฎหมาย แต่สำหรับข้อยกเว้นทั่วไป เจ้าของสิทธิสามารถ สงวนสิทธิ์หรือ opt out ได้ และในกรณีเนื้อหาออนไลน์ กฎหมายระบุถึงการสงวนสิทธิ์ในลักษณะที่เหมาะสม เช่น machine-readable means
นอกจากนี้ EU AI Act ยังเพิ่มหน้าที่สำหรับผู้ให้บริการ general-purpose AI ให้มีนโยบายปฏิบัติตามกฎหมายลิขสิทธิ์ของสหภาพยุโรป เคารพการสงวนสิทธิ์ และจัดทำ สรุปเนื้อหาที่ใช้ฝึกโมเดลซึ่งมีรายละเอียดเพียงพอและเปิดเผยต่อสาธารณะ ตาม template ของ AI Office
ตรงนี้ต้องระวังอีกอย่าง
กฎหมายไม่ได้กำหนดให้บริษัทต้องเปิด dataset ทุกไฟล์ต่อสาธารณะ
มันกำหนดให้มี sufficiently detailed summary ซึ่งอาจรวม dataset หลัก แหล่งข้อมูล และ domain สำคัญ ไม่ใช่การเปิด training corpus ทั้งหมด
ส่วนญี่ปุ่นมี Article 30-4 ซึ่งเปิดพื้นที่กว้างสำหรับการใช้ผลงานในวัตถุประสงค์ที่ไม่ได้มุ่ง “enjoy” ความคิดหรือความรู้สึกที่แสดงในผลงาน เช่น data analysis และ AI development
แต่กฎหมายญี่ปุ่นก็ไม่ได้เขียนว่า
“AI เอางานอะไรก็ได้ไปใช้โดยไม่มีข้อจำกัด”
เพราะข้อยกเว้นไม่ใช้หากการใช้ดังกล่าว กระทบผลประโยชน์ของเจ้าของลิขสิทธิ์อย่างไม่สมเหตุสมผล โดยพิจารณาจากธรรมชาติ วัตถุประสงค์ และบริบทของการใช้
เพราะฉะนั้นเราอาจต้องเลิกถามว่า “AI Training ผิดไหม?”
แล้วเปลี่ยนเป็นถามว่า
AI ตัวไหน
ใช้ข้อมูลอะไร
เอามาจากไหน
ภายใต้กฎหมายประเทศไหน
ใช้ด้วยวัตถุประสงค์อะไร
มีการสงวนสิทธิ์ไหม
output ทำอะไรได้
และมันกระทบตลาดใครบ้าง
เพราะเราอาจพบว่าใน pipeline เดียวกัน
บางขั้นตอนชอบด้วยกฎหมาย
บางขั้นตอนยังเป็นพื้นที่สีเทา
และบางขั้นตอนอาจละเมิด
พร้อมกันทั้งหมดก็ได้
นี่ไม่ใช่การพูดเข้าข้างบริษัท AI
และไม่ใช่การบอกศิลปินว่า “ยอม ๆ ไปเถอะ เทคโนโลยีมาแล้ว”
ในทางกลับกัน มันก็ไม่ได้แปลว่าการพบงานเราอยู่ใน training data จะพิสูจน์โดยอัตโนมัติว่า
“บริษัทแพ้คดีลิขสิทธิ์เรียบร้อยแล้ว”
สิ่งที่น่าสนใจสำหรับเราคือ ตอนนี้กฎหมายเริ่มขยับจากคำถามง่าย ๆ ว่า
“AI ขโมยหรือไม่?”
ไปสู่คำถามที่ละเอียดขึ้นว่า
เราจะสร้างระบบที่ให้เทคโนโลยีพัฒนาได้ โดยที่สิทธิของคนสร้างงานไม่ถูกทำให้ไร้ความหมายได้อย่างไร
เราเริ่มเห็นคำตอบหลายแบบเกิดขึ้นพร้อมกัน
Fair Use
TDM exceptions
Opt-out
Transparency
Data provenance
Licensing
และการแยกความรับผิดระหว่างการหาข้อมูล การเทรน และผลลัพธ์
สำหรับเรา นี่น่าจะเป็นทิศทางที่มีประโยชน์กว่าการยืนตะโกนกันคนละฝั่งว่า
“AI ทุกอย่างคือการขโมย”
หรือ
“AI เรียนรู้เหมือนมนุษย์ เพราะฉะนั้นไม่มีปัญหาอะไรเลย”
เพราะจากคดีที่เกิดขึ้นจริงจนถึงตอนนี้
กฎหมายกำลังบอกเราว่า ไม่มีประโยคไหนง่ายขนาดนั้น
และบางทีอนาคตของ AI กับศิลปินอาจไม่ได้ถูกตัดสินด้วยคำถามว่า
ใครต้องหายไป
แต่อยู่ที่ว่า
เราจะสร้างกติกาแบบไหน เพื่อให้ทั้งคนสร้างเทคโนโลยีและคนสร้างวัฒนธรรมยังมีเหตุผลที่จะสร้างสิ่งใหม่ต่อไป
หมายเหตุ: บทความนี้อธิบายภาพรวมเชิงข้อมูล ไม่ใช่คำปรึกษากฎหมาย และสถานะคดี/กฎหมายอ้างอิงตรวจถึงวันที่ 16 กันยายน 2026